Foneo hoạt động như thế nào? Giải thích Stable Diffusion dễ hiểu cho người làm ảnh
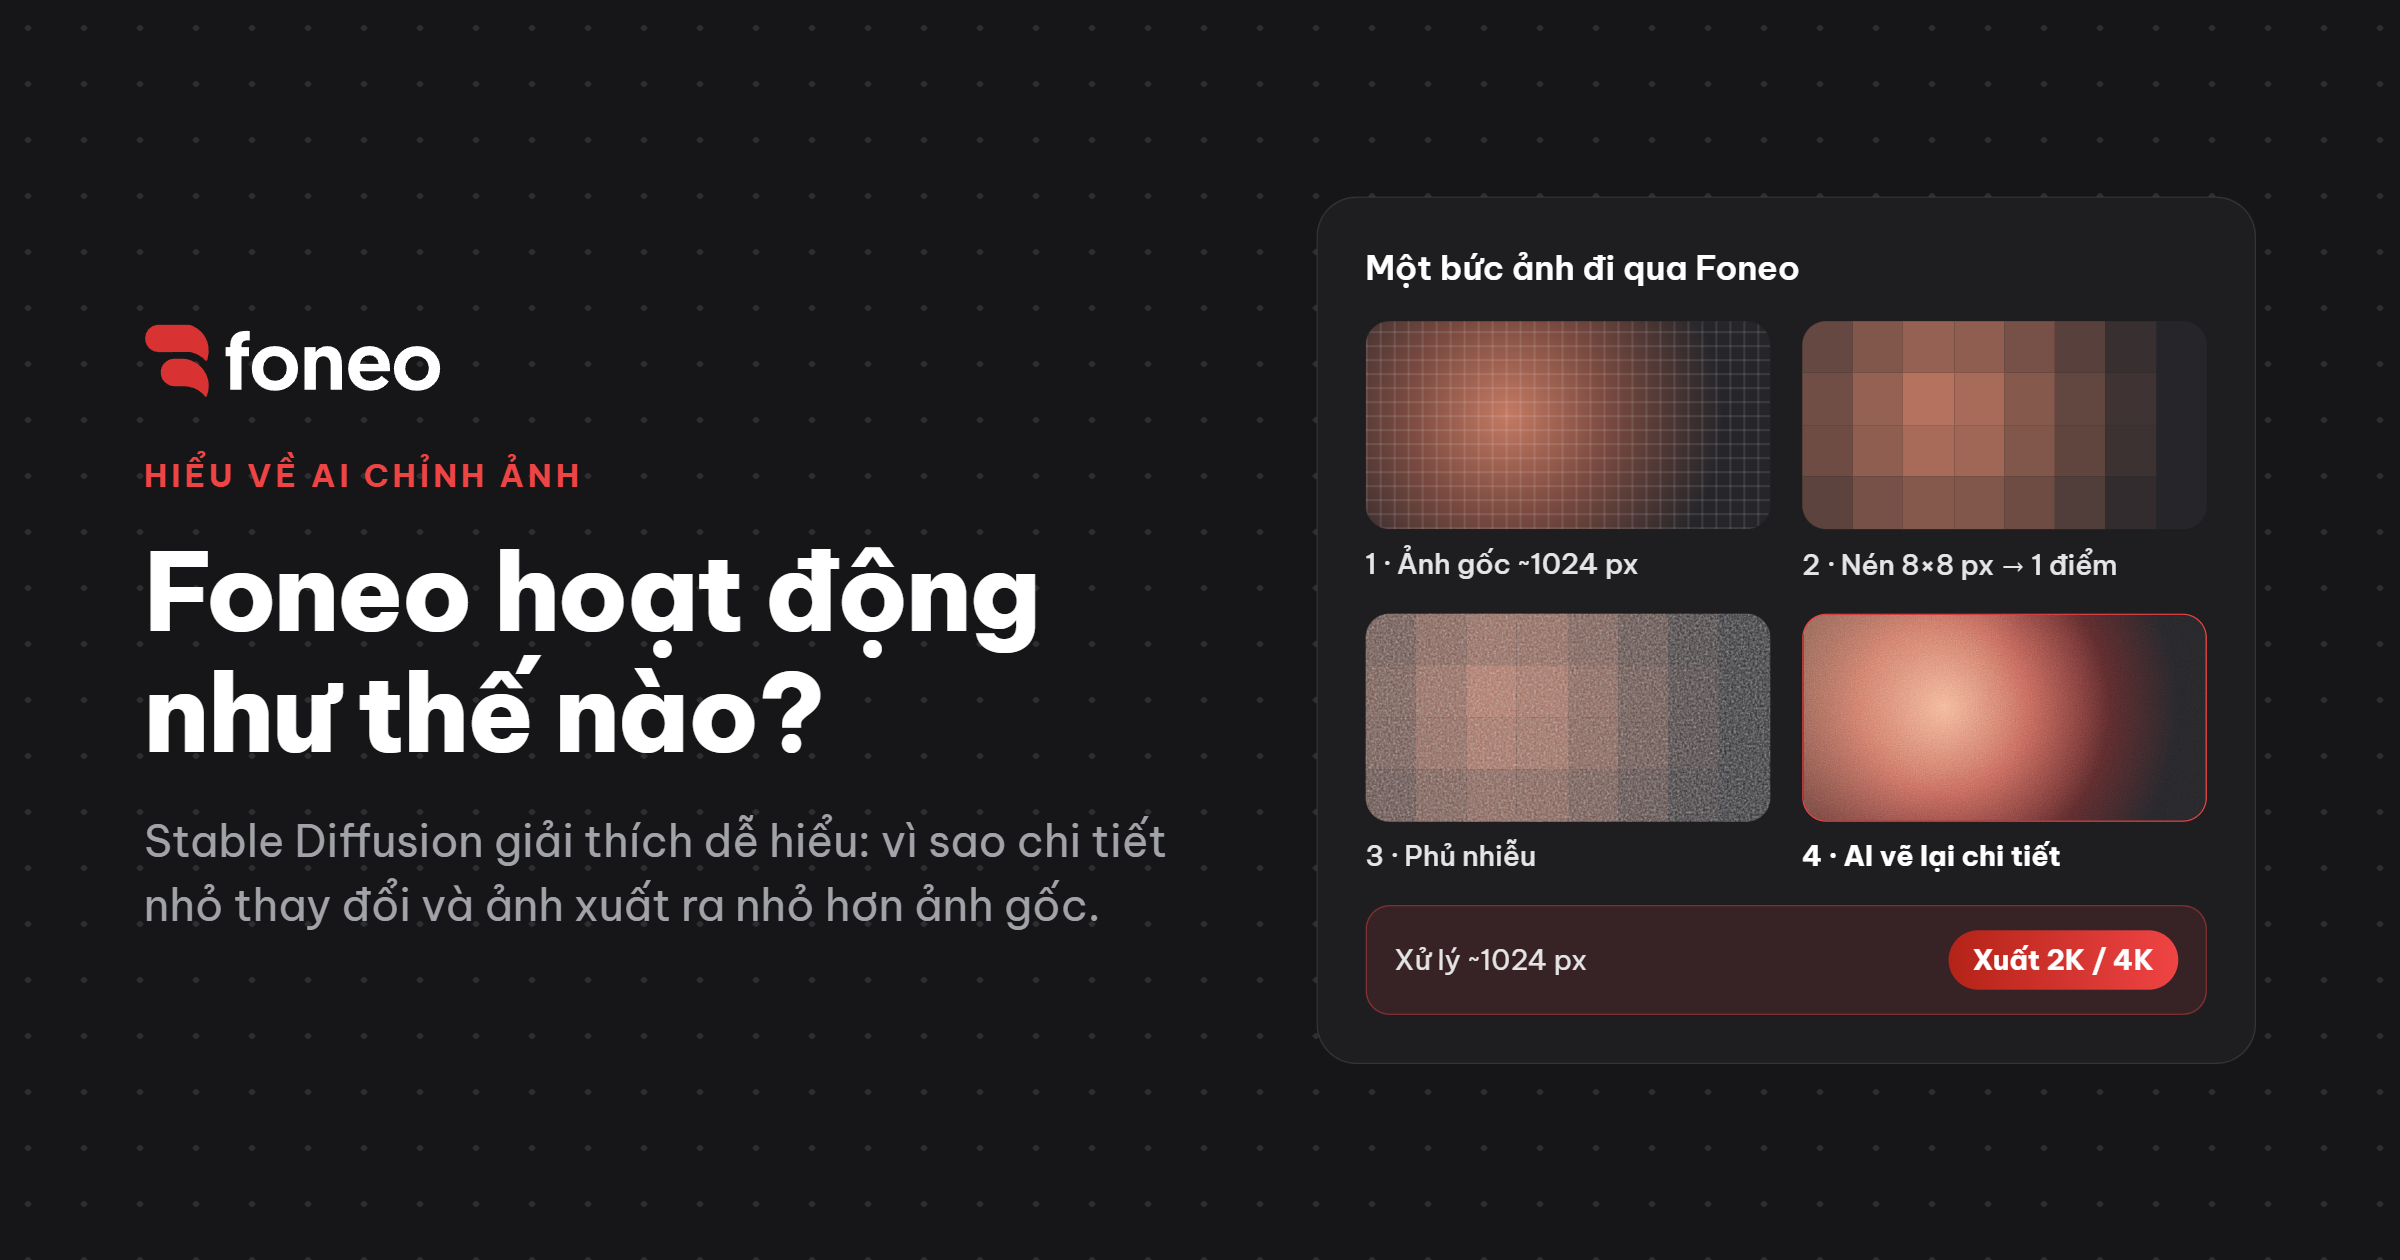
Bạn xử lý một bức chân dung bằng Foneo và kết quả nhìn tổng thể rất đẹp. Nhưng khi phóng lên 100%, bạn thấy hoa tai đổi kiểu, chữ trên áo hơi méo, và file xuất ra nhỏ hơn ảnh gốc 24MP từ máy ảnh.
Đó không phải lỗi. Đó là bản chất của cách AI tạo sinh làm việc. Bài này giải thích cơ chế đó bằng ví dụ đời thường, không công thức, không code. Đọc xong, bạn sẽ biết vì sao chuyện này xảy ra, khi nào nên tin AI, và cách lấy lại chi tiết gốc khi cần.
AI không "chỉnh" ảnh, AI "vẽ lại" ảnh
Khi bạn kéo Exposure hay Curve trong Lightroom, phần mềm thay đổi giá trị của những pixel đã có. Không pixel nào được tạo mới.
Stable Diffusion làm việc theo cách khác hẳn. Nó giống một họa sĩ rất giỏi: nhìn ảnh của bạn, hiểu yêu cầu (chẳng hạn "thêm nắng chiều"), rồi vẽ lại bức ảnh theo yêu cầu đó. Bức vẽ giống ảnh gốc về bố cục, ánh sáng, gương mặt, nhưng họa sĩ không sao chép từng pixel.
Stable Diffusion là một họ model AI tạo ảnh, được huấn luyện trên hàng trăm triệu đến hàng tỷ bức ảnh. Qua đó nó học được da người trông ra sao, ánh sáng rơi trên vải thế nào, bầu trời lúc hoàng hôn có màu gì. Tất cả công cụ AI trong Foneo đều dùng các model thuộc họ Stable Diffusion. Việc của Foneo là chọn model phù hợp cho từng tác vụ và đóng gói thành công cụ dễ dùng.
Một bức ảnh đi qua Foneo như thế nào: 5 bước
Quy trình xử lý ảnh bằng Stable Diffusion trong Foneo 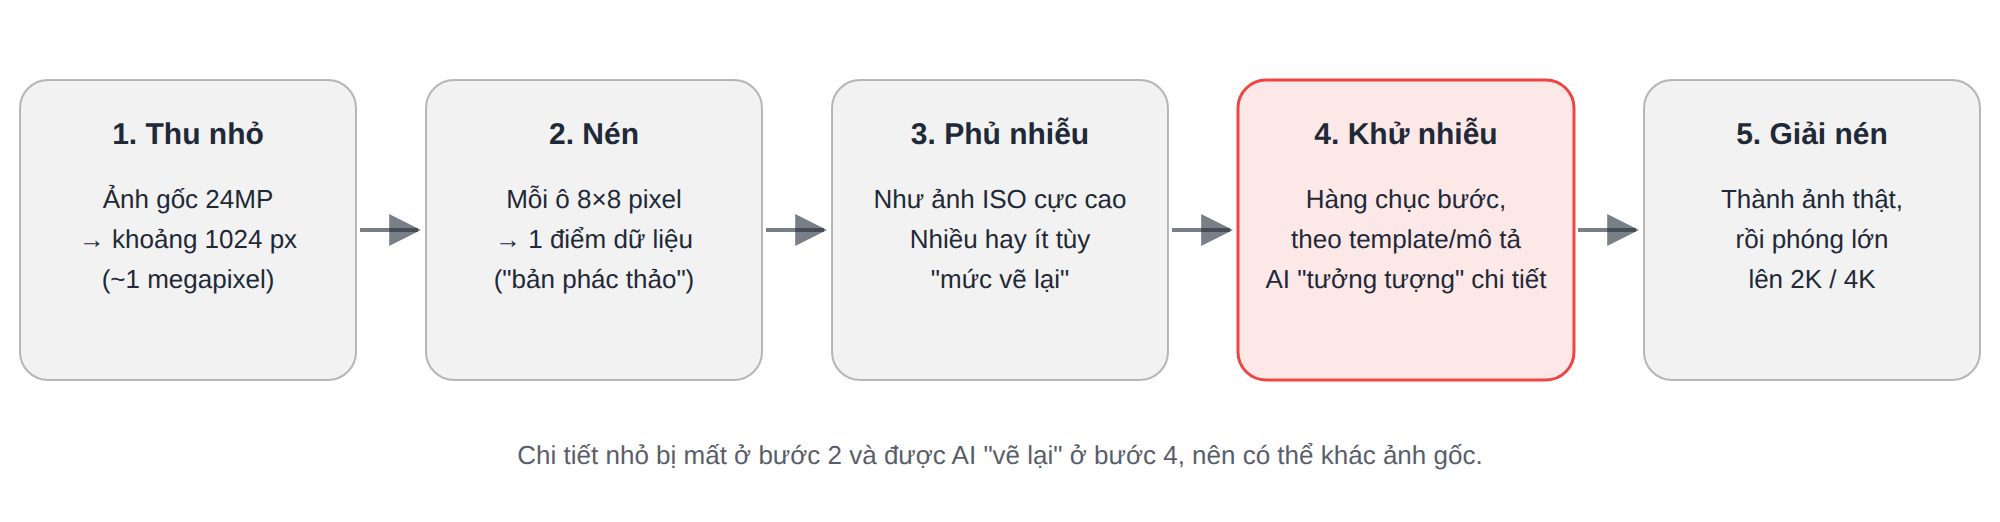 Hình 1. Năm bước một bức ảnh đi qua khi xử lý bằng Stable Diffusion trong Foneo.Bước 1: Thu nhỏ ảnh về khoảng 1024 px
Foneo đưa ảnh về độ phân giải chuẩn khoảng 1024 px, tương đương cỡ 1 megapixel. Đây là kích thước mà model được huấn luyện để vẽ tốt nhất. Phần "Vì sao ảnh sau xử lý nhỏ hơn ảnh gốc" bên dưới giải thích lý do.
Bước 2: Nén ảnh thành một "bản phác thảo"
Stable Diffusion không vẽ trực tiếp trên pixel. Nó nén ảnh thành một dạng dữ liệu gọn hơn, gọi là latent: mỗi ô 8×8 pixel (64 pixel) được gói lại thành một điểm dữ liệu. Ảnh 1024×1024 px chỉ còn một "bản phác thảo" 128×128 điểm.
Hãy hình dung bạn tả một bức ảnh cho người khác qua điện thoại. Bạn sẽ nói "cô gái mặc váy trắng, nắng chiều bên trái", chứ không tả từng sợi tóc. Bản phác thảo giữ tốt bố cục, màu sắc, ánh sáng, nhưng những chi tiết nhỏ hơn một ô 8×8 thì không còn nguyên vẹn.
Bước 3: Phủ nhiễu lên bản phác thảo
Tiếp theo, model phủ một lớp nhiễu ngẫu nhiên lên bản phác thảo, giống ảnh chụp ở ISO cực cao. Phủ nhiều hay ít phụ thuộc vào mức độ vẽ lại (trong Stable Diffusion gọi là denoise strength): phủ ít thì kết quả bám sát ảnh gốc, phủ nhiều thì AI có nhiều chỗ để sáng tạo hơn, chẳng hạn khi thay nền hoặc thay trang phục.
Bước 4: Khử nhiễu từng bước theo hướng dẫn
Đây là phần "vẽ" thật sự. Qua hàng chục bước, model gỡ dần lớp nhiễu. Ở mỗi bước, nó tự hỏi: "với hướng dẫn này, bức ảnh đúng ra phải trông thế nào?" Hướng dẫn có thể là template bạn chọn, câu mô tả bạn nhập, hoặc ảnh tham chiếu (như trong Sao chép kiểu chụp).
Chính ở bước này AI "tưởng tượng" ra những chi tiết đã mất ở bước 2, dựa trên những gì nó đã học từ hàng trăm triệu bức ảnh khác.
Bước 5: Giải nén và phóng lớn
Bản phác thảo đã hoàn thiện được giải nén trở lại thành ảnh pixel, rồi được phóng lớn bằng AI khi xuất: tối đa 4K với gói trả phí, 2K với gói miễn phí.
Vì sao chi tiết nhỏ hay bị sai khác so với ảnh gốc?
Gộp lại từ 5 bước trên, có bốn nguyên nhân chính.
1. Chi tiết nhỏ bị mất khi nén
Một ô 8×8 pixel chỉ còn một điểm dữ liệu. Hoa văn trên vải, sợi tóc lòa xòa, chữ nhỏ, vân da, họa tiết trang sức là những thứ mất đi trước tiên.
2. AI "đoán" lại chi tiết theo những gì nó đã học
Ở bước khử nhiễu, AI vẽ lại chi tiết sao cho hợp lý, không phải sao cho đúng với ảnh gốc. Hoa tai vẫn là hoa tai, nhưng có thể đổi kiểu. Cúc áo vẫn có, nhưng số lượng có thể lệch. Giống một họa sĩ vẽ lại chân dung: gương mặt rất giống, nhưng chiếc khuyên tai thì họa sĩ vẽ theo trí nhớ.
3. Chủ thể càng nhỏ trong khung, AI càng ít thông tin
Nếu một khuôn mặt chỉ chiếm khoảng 100 px trong vùng 1024 px mà AI xử lý, sau khi nén nó chỉ còn khoảng 12×12 điểm dữ liệu. Với lượng thông tin ít như vậy, AI rất dễ vẽ ra một gương mặt "gần giống" chứ không phải chính người đó. Đó là lý do ảnh đông người, người đứng xa hay bàn tay nhỏ trong khung hình thường dễ sai hơn ảnh chân dung cận.
4. Mỗi lần chạy mỗi khác
Lớp nhiễu ở bước 3 được tạo ngẫu nhiên (trong Stable Diffusion gọi là seed). Nhiễu khác thì bức vẽ ra cũng khác. Vì vậy bấm xử lý lại cùng một ảnh sẽ cho kết quả không giống lần trước, và đôi khi lần sau đẹp hơn.
Những chi tiết dễ sai nhất
- Chữ và logo: AI học hình dáng chữ như một loại hoa văn, nó không "đọc" chữ, nên nét chữ nhỏ dễ méo hoặc biến thành ký tự lạ.
- Bàn tay và ngón tay: nhiều khớp, nhiều tư thế, thường nhỏ trong khung hình.
- Trang sức và phụ kiện: nhỏ, nhiều chi tiết lặp, phản chiếu ánh sáng phức tạp.
- Mắt và nhận dạng khuôn mặt: chỉ lệch vài pixel đã thấy "khác người".
- Hoa văn lặp lại: vải kẻ sọc, gạch lát, lưới, rèm.
Cách lấy lại chi tiết gốc trong Foneo
- Xuất file PSD. File có sẵn lớp ảnh gốc và lớp ảnh đã xử lý. Chỉ cần tạo mask để lấy lại hoa tai, chữ hay bàn tay từ ảnh gốc, phần còn lại giữ kết quả AI.
- Dùng công cụ chuyên biệt: Làm nét khuôn mặt, Tăng chi tiết, Tăng độ phân giải được thiết kế để giữ chi tiết tốt hơn.
- Dùng ảnh gốc chất lượng cao và để chủ thể chiếm phần lớn khung hình; crop sát vùng quan trọng trước khi xử lý nếu cần.
- Chạy 2–3 lần rồi chọn bản đẹp nhất. Gói trả phí của Foneo không tính phí theo lượt, nên bạn thử thoải mái.
Vì sao ảnh sau xử lý nhỏ hơn ảnh gốc từ máy ảnh?
Ảnh từ máy ảnh hiện nay thường có 24–60 megapixel. Trong khi đó, Stable Diffusion làm việc tốt nhất ở khoảng 1 megapixel. Có ba lý do khiến không thể cho AI vẽ thẳng ở kích thước gốc.
1. Model được "dạy" để vẽ ở khoảng 1 megapixel
Stable Diffusion học từ những bức ảnh cỡ khoảng 1024 px. Ép nó vẽ một lần ở kích thước lớn hơn nhiều giống như bắt một họa sĩ quen vẽ khổ A4 vẽ cả bức tranh tường mà không được lùi ra nhìn tổng thể. Kết quả thường là lỗi bố cục: chủ thể bị lặp (hai cái đầu, bốn cánh tay), chi tiết rời rạc, mảng màu vỡ.
2. Chi phí tính toán tăng rất nhanh theo kích thước
Gấp đôi mỗi cạnh ảnh thì số pixel tăng gấp 4, còn phần tính toán nặng nhất của model (phần "chú ý", attention, giúp model nhìn mối liên hệ giữa các vùng trong ảnh) có thể tăng tới khoảng 16 lần. Một ảnh 24MP lớn gấp khoảng 23 lần vùng 1 megapixel, nên sẽ cần nhiều GPU và thời gian hơn rất nhiều. Chi phí đó cuối cùng sẽ nằm trong giá gói của người dùng.
3. Vì vậy quy trình thực tế là: thu nhỏ → xử lý → phóng lớn
Foneo xử lý ở khoảng 1024 px, rồi phóng lớn kết quả bằng AI lên 2K hoặc 4K khi xuất. Bảng dưới giúp bạn hình dung các kích thước này:
So sánh kích thước ảnh (tỷ lệ 3:2)| Loại ảnh | Kích thước (px) | Megapixel |
|---|---|---|
| Vùng AI xử lý trong Foneo | khoảng 1024 px | ~1 MP |
| Xuất 2K (gói miễn phí) | ~2048 × 1365 | ~2,8 MP |
| Xuất 4K (gói trả phí) | ~3840 × 2560 | ~9,8 MP |
| Máy ảnh 24MP | 6000 × 4000 | 24 MP |
| Máy ảnh 45MP | 8192 × 5464 | ~45 MP |
Ảnh 4K dùng được cho những gì?
Ảnh 4K (cạnh dài khoảng 3840 px) đủ cho mạng xã hội, website, album online và màn hình 4K. Khi in, 4K cho ảnh đẹp khổ khoảng 22 × 32 cm ở 300 dpi (vừa khổ A4), hoặc khoảng 32 × 49 cm ở 200 dpi (vừa khổ A3).
Nếu cần file lớn hơn để in khổ lớn: mở file PSD trong Photoshop, đặt lớp AI lên ảnh gốc độ phân giải cao, rồi chỉ giữ phần AI ở những vùng thật sự thay đổi (ánh sáng, nền, vật thể đã xóa). Những vùng còn lại lấy từ ảnh gốc, giữ nguyên độ nét của máy ảnh.
Vì sao Foneo đơn giản mà vẫn cho kết quả tốt?
Mọi thứ ở trên đều có thể tự làm bằng Stable Diffusion, chẳng hạn qua ComfyUI. Nhưng muốn có một kết quả ổn định cho một tác vụ, bạn phải tự quyết định hàng chục thứ:
Tự dùng Stable Diffusion so với dùng Foneo| Việc cần làm | Tự làm với Stable Diffusion / ComfyUI | Dùng Foneo |
|---|---|---|
| Cài đặt | Cài ComfyUI, tải model nặng hàng GB, cài thêm node mở rộng | Cài app Foneo, đăng nhập |
| Phần cứng | Card đồ họa nhiều VRAM (thường từ 8 GB trở lên) hoặc thuê server GPU | Không cần: xử lý trên server của Foneo |
| Chọn model | Tự chọn checkpoint, LoRA, ControlNet cho từng việc | Foneo chọn sẵn cho từng công cụ |
| Thông số | Tự chỉnh sampler, steps, CFG, denoise, seed | Đã tinh chỉnh sẵn |
| Prompt | Tự viết prompt và negative prompt | Template có sẵn; mô tả là tùy chọn |
| Workflow | Tự nối node, sửa khi lỗi, cập nhật khi model mới ra | Chọn công cụ → thả ảnh → xử lý |
| Chi phí | Tiền GPU hoặc tiền thuê server theo giờ | Gói tháng/năm, không tính phí theo lượt |
Foneo không tự xây model AI nền tảng. Giá trị của Foneo nằm ở phần việc ở giữa: chọn model Stable Diffusion phù hợp cho từng tác vụ, thiết lập sẵn thông số, template và quy trình, rồi chạy tất cả trên server. Mỗi công cụ trong Foneo là một workflow đã được thử nghiệm kỹ, để kết quả ổn định và dễ đoán.
Với người dùng, mọi thứ chỉ còn là: chọn công cụ, thả ảnh, xử lý. No prompts. No models. No nodes. Just edit. Foneo là một ứng dụng chỉnh ảnh, không phải một phòng thí nghiệm AI.
Mẹo để có kết quả tốt nhất
- Dùng ảnh gốc nét, đủ sáng; chủ thể chiếm phần lớn khung hình.
- Cần giữ chi tiết khuôn mặt trong ảnh đông người? Crop sát vùng đó trước khi xử lý.
- Chạy 2–3 lần rồi chọn bản đẹp nhất.
- Luôn kiểm tra ở 100% trước khi giao khách, đặc biệt chữ, bàn tay, trang sức.
- Dùng file PSD để lấy lại chi tiết gốc ở những vùng AI không cần thay đổi.
Câu hỏi thường gặp
Vì sao mỗi lần xử lý cùng một ảnh lại ra kết quả khác nhau?
Mỗi lần xử lý, Stable Diffusion bắt đầu từ một lớp nhiễu ngẫu nhiên khác nhau. Nhiễu khác thì kết quả khác. Bạn có thể chạy lại vài lần và chọn bản đẹp nhất.
Vì sao khuôn mặt đôi khi hơi khác người thật?
Khi khuôn mặt nhỏ trong khung hình, sau khi nén nó chỉ còn rất ít điểm dữ liệu, nên AI phải vẽ lại nhiều chi tiết. Hãy dùng ảnh có khuôn mặt đủ lớn, crop sát trước khi xử lý, dùng công cụ Làm nét khuôn mặt, hoặc lấy lại vùng mặt gốc bằng file PSD.
Vì sao chữ và logo trong ảnh hay bị méo?
AI học hình dáng chữ như hoa văn, không đọc được chữ, và nét chữ nhỏ bị mất khi nén. Nếu ảnh có chữ hoặc logo quan trọng, hãy lấy lại vùng đó từ lớp ảnh gốc trong file PSD.
Foneo có dùng card đồ họa trên máy tôi không?
Không. Ảnh được gửi lên server của Foneo để xử lý, nên máy tính của bạn không cần cấu hình mạnh. Đổi lại, bạn cần kết nối internet khi dùng Foneo.
Vì sao mỗi ảnh mất khoảng 2 phút?
Mỗi ảnh đi qua hàng chục bước khử nhiễu, rồi được phóng lớn lên 2K hoặc 4K, cộng thời gian gửi và nhận ảnh. Các gói dài hạn có mức ưu tiên xử lý cao hơn.
Ảnh 4K có đủ để in không?
Đủ cho khổ khoảng 22 × 32 cm ở 300 dpi (vừa khổ A4), hoặc khoảng 32 × 49 cm ở 200 dpi (vừa khổ A3). Cần in lớn hơn, hãy ghép lớp AI vào ảnh gốc bằng file PSD.
Foneo có lưu ảnh hoặc dùng ảnh của tôi để huấn luyện AI không?
Foneo không dùng ảnh của người dùng để huấn luyện AI và không lưu ảnh vĩnh viễn. Ảnh tải lên và ảnh kết quả chỉ được giữ tạm trên server tối đa khoảng 48 giờ để trả kết quả cho bạn, sau đó tự động bị xóa. Chi tiết xem tại Chính sách quyền riêng tư.
Foneo có nhận ảnh RAW không?
Không. Foneo nhận các định dạng ảnh raster thông dụng như JPG và PNG. Với ảnh RAW, hãy xuất ra JPG hoặc PNG từ Lightroom hay Capture One trước khi đưa vào Foneo.
Tóm lại
AI mạnh ở phần "tưởng tượng": ánh sáng mới, nền mới, chi tiết mới. Ảnh gốc mạnh ở phần "chính xác": từng sợi tóc, từng con chữ, độ phân giải của máy ảnh. Một workflow tốt kết hợp cả hai, và file PSD của Foneo được thiết kế để làm đúng việc đó.
Xem thêm hướng dẫn từng tính năng trên blog Foneo, hoặc tải Foneo và dùng thử miễn phí 3 ngày.
Foneo · Chỉnh ảnh AI
Sẵn sàng thử ngay trên ảnh của bạn?
Tải ứng dụng Foneo để chỉnh ảnh bằng AI chỉ với vài thao tác, hoặc xem gói phù hợp với nhu cầu của bạn.